30 多种语言 OCR 与它的识别极限:哪些字认不出来
OCR 不是点石成金:语言对、字迹清,识别又快又准;条件不满足时它会坦率地失败。这一页讲清边界,让你预判哪些活能干、哪些要留后手。
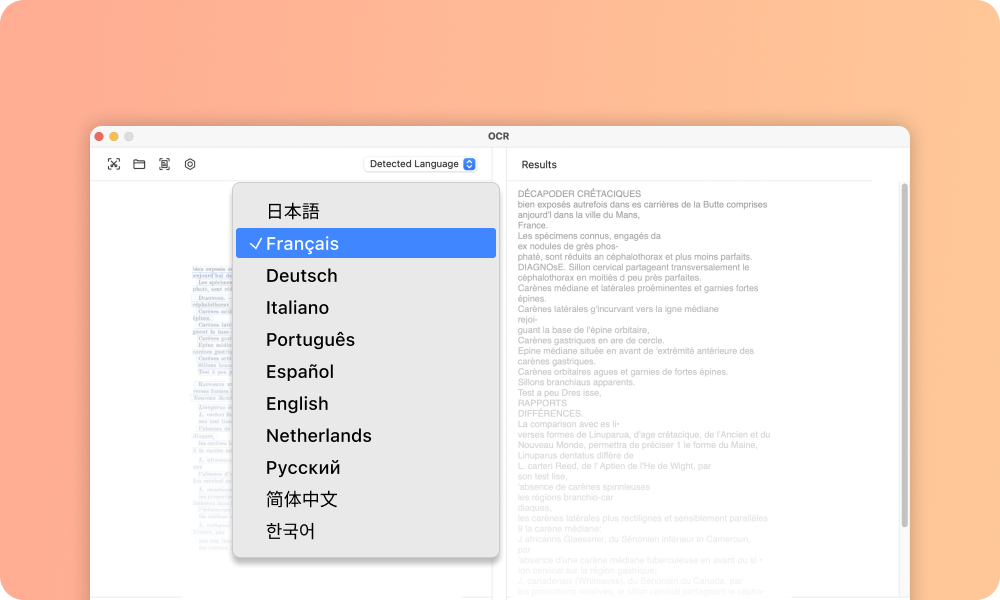
语言支持范围
官方口径:文档转换用 OCR 支持 30 多种语言,区域提取 OCR 支持 10 多种语言。全球用户不管文档用什么语言,都能识别其文本——这是官方多语言页的表述。
识别失败的高发情形
官方 FAQ 逐条点过名,整理如下:
- 手写体:识别不了。手写内容老老实实人工录入。
- 不常见字体:官方明确"可能无法识别手写体、不常见字体或图形"。
- 扫描质量差:扫描件的质量直接影响识别准确率——模糊、歪斜、漏光都会拉低命中率。
- 复杂排版:包含表格、分栏或图形等高级格式时,转换过程可能出现错误,"可能并不总是保留原始 PDF 的格式"。
- 图形内容:图片里的图表、印章下的文字,属于"图形"范畴,识别不可靠。
实用对策
| 情况 | 对策 |
|---|---|
| 扫描件模糊 | 提高扫描分辨率重扫,300 DPI 起步 |
| 表格串行 | 改用区域 OCR 逐格框选 |
| 分栏串行 | 按栏分别框选,或先转 Word 手动归位 |
| 关键数字存疑 | 对照原图逐个核对,数字是最不能错的 |
| 识别结果乱码 | 确认识别语言设置与文档语言一致 |
一个诚实的提醒
官方 FAQ 同时说了公道话:OCR 转换后格式可能不总是保留,特别是表格、分栏、图形密集的文档——这与转换后格式为什么不乱讲的转换保真逻辑同理,保真是尽力而为的工程目标,不是绝对承诺。重要文件转完必须通读校对,识别质量以官方最新版为准。
- 全文转换的入口与流程,见扫描件转 Word。
- 转出格式怎么选,看 PDF 转 Word。